Web scraping là gì? Thu thập dữ liệu công khai đúng luật, lịch sự và vai trò của proxy
Web scraping là gì, dùng để làm gì, và bốn nguyên tắc thu thập dữ liệu công khai cho đúng: tôn trọng robots.txt theo RFC 9309, đi chậm và nghe mã 429, cẩn thận với dữ liệu cá nhân, đọc điều khoản. Cuối bài là vai trò của scraping proxy.
Mục lục
- Web scraping dùng để làm gì?
- Nguyên tắc 1: Đọc và tôn trọng robots.txt
- Nguyên tắc 2: Đi chậm, và chậm lại khi website yêu cầu
- Nguyên tắc 3: Cẩn thận với dữ liệu cá nhân
- Nguyên tắc 4: Đọc điều khoản và lấy vừa đủ
- Proxy nằm ở đâu trong web scraping?
- Câu hỏi thường gặp
- Web scraping có hợp pháp không?
- robots.txt có bắt buộc phải theo không?
- Nên giãn cách giữa các yêu cầu bao lâu?
- Scraping proxy là gì?
- Có cần proxy để làm web scraping không?
"Web scraping", hay thu thập dữ liệu web, là việc dùng chương trình để tự động lấy nội dung từ các trang web thay vì sao chép bằng tay. Cơ quan bảo vệ dữ liệu của Anh (ICO) mô tả nó là quá trình tự động "cào" nội dung, có thể gồm cả dữ liệu cá nhân, từ một trang web rồi lưu lại để xử lý tiếp. Doanh nghiệp dùng nó để theo dõi giá, nghiên cứu thị trường, theo dõi thứ hạng tìm kiếm hay xây dữ liệu cho AI. Bài này giải thích web scraping là gì, làm sao thu thập dữ liệu công khai cho đúng luật và lịch sự, và proxy (scraping proxy) nằm ở đâu trong chuyện này.
Web scraping dùng để làm gì?
Một số việc phổ biến và chính đáng:
- Theo dõi giá: xem giá, khuyến mãi, tình trạng còn hàng của sản phẩm trên các trang bán lẻ công khai.
- Nghiên cứu thị trường: gom thông tin công khai về sản phẩm, đánh giá, xu hướng để ra quyết định.
- SEO: theo dõi thứ hạng của từ khoá ở từng quốc gia, từng thành phố.
- Kiểm tra quảng cáo: xem quảng cáo có hiển thị đúng nơi, đúng nội dung không.
- Dữ liệu cho AI và phân tích: tập hợp văn bản, số liệu công khai để huấn luyện hay phân tích.
Nguyên tắc 1: Đọc và tôn trọng robots.txt
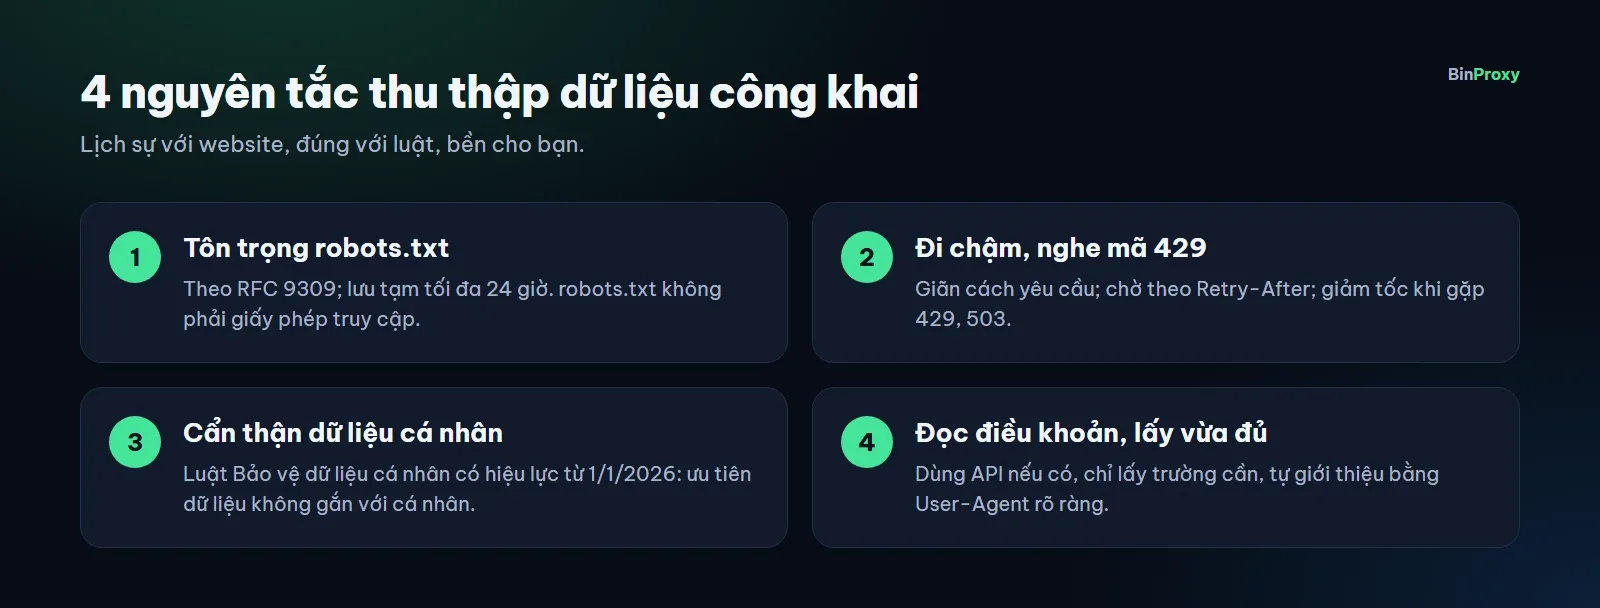
Hầu hết website có một tệp robots.txt nói cho chương trình tự động biết phần nào nên và không nên truy cập. Quy chuẩn của tệp này là RFC 9309, được IETF công bố tháng 9/2022. Vài điểm đáng biết từ chính văn bản đó:
- Các quy tắc trong robots.txt không phải một hình thức cấp quyền truy cập. Nói cách khác, robots.txt cho phép không có nghĩa là bạn được làm mọi thứ, và chặn trong robots.txt không thay cho biện pháp bảo mật.
- Chương trình thu thập có thể lưu tạm robots.txt, nhưng không nên dùng bản lưu quá 24 giờ.
- Trình đọc robots.txt phải đọc được tệp ít nhất 500 KiB.
Các công cụ lớn đều làm theo. Ví dụ, khi bạn tạo dự án mới với Scrapy, một thư viện thu thập dữ liệu mã nguồn mở rất phổ biến, cài đặt ROBOTSTXT_OBEY được bật sẵn.
Nguyên tắc 2: Đi chậm, và chậm lại khi website yêu cầu
Một chương trình gửi hàng trăm yêu cầu mỗi giây có thể làm chậm cả website của người khác. Thu thập dữ liệu lịch sự nghĩa là:
- Giãn cách giữa các yêu cầu. Dự án Scrapy mới mặc định chờ 1 giây giữa hai yêu cầu tới cùng một tên miền (
DOWNLOAD_DELAY), và Scrapy còn có tính năng AutoThrottle tự điều chỉnh tốc độ theo độ phản hồi của website, với mục tiêu ghi rõ là "tử tế hơn với các website". - Nghe mã 429. Theo RFC 6585, mã 429 nghĩa là bạn đã gửi quá nhiều yêu cầu trong một khoảng thời gian, và website có thể kèm tiêu đề
Retry-Afterđể nói bạn nên chờ bao lâu. - Làm như Google. Chính Google hướng dẫn rằng khi website trả về mã 500, 503 hoặc 429, trình thu thập của Google sẽ giảm tốc độ trên toàn bộ tên miền đó, và chỉ tăng lại khi lỗi giảm.
Một chương trình đi chậm, biết dừng khi được yêu cầu, sẽ chạy bền hơn nhiều so với một chương trình chạy hết tốc lực rồi bị lỗi liên tục.
Nguyên tắc 3: Cẩn thận với dữ liệu cá nhân
Dữ liệu "công khai" trên mạng không có nghĩa là muốn dùng thế nào cũng được. ICO của Anh lưu ý rằng luật bảo vệ dữ liệu vẫn áp dụng cho dữ liệu cá nhân công khai bị thu thập. Ở Việt Nam, Luật Bảo vệ dữ liệu cá nhân số 91/2025/QH15 có hiệu lực từ ngày 1/1/2026, yêu cầu sự đồng ý cho từng mục đích và có mức phạt rất nặng với việc mua bán dữ liệu cá nhân.
Cách an toàn nhất là chỉ thu thập dữ liệu không gắn với cá nhân: giá, tên sản phẩm, thứ hạng tìm kiếm, nội dung quảng cáo. Nếu công việc buộc phải đụng tới dữ liệu cá nhân, hãy hỏi ý kiến người có chuyên môn pháp lý trước.
Nguyên tắc 4: Đọc điều khoản và lấy vừa đủ
- Đọc điều khoản sử dụng của website. Nhiều website có API chính thức hoặc tệp dữ liệu công khai: dùng chúng vừa nhẹ cho bạn vừa nhẹ cho website.
- Chỉ lấy những trường dữ liệu bạn thật sự cần, và chỉ khi bạn cần. Lấy ít hơn nghĩa là ít yêu cầu hơn, ít dung lượng hơn.
- Tự giới thiệu mình bằng một User-Agent rõ ràng, có cách liên hệ, để quản trị website biết ai đang truy cập.
Proxy nằm ở đâu trong web scraping?
Proxy, và nhất là proxy dân cư, giúp web scraping ở hai việc chính đáng:
- Lấy kết quả đúng vùng. Giá, nội dung và kết quả tìm kiếm thường khác nhau theo quốc gia, tỉnh, thành phố. Proxy cho bạn chọn IP ở đúng nơi cần xem.
- Chạy từ máy chủ ở nơi khác. Hệ thống thu thập thường đặt trên máy chủ đám mây ở nước ngoài, và proxy cho nó một IP ở đúng quốc gia bạn nghiên cứu.
Proxy không thay cho các nguyên tắc ở trên. Một chương trình lịch sự, tôn trọng robots.txt và mã 429, chạy qua proxy xoay sẽ vừa nhẹ cho website vừa ổn định cho bạn. Nếu bạn mới bắt đầu, bài cách dùng proxy với Python requests có sẵn code tự giảm tốc khi gặp lỗi 429, còn bài proxy đổi IP là gì giải thích khi nào nên xoay IP, khi nào nên giữ IP. BinProxy tính theo GB, bạn xem bảng giá nhé.
Câu hỏi thường gặp
Web scraping có hợp pháp không?
Thu thập dữ liệu công khai, không gắn với cá nhân, theo cách không gây hại cho website thường được chấp nhận rộng rãi. Ranh giới nằm ở loại dữ liệu bạn lấy (nhất là dữ liệu cá nhân), cách bạn lấy và điều khoản của website. Khi không chắc, hãy hỏi người có chuyên môn pháp lý.
robots.txt có bắt buộc phải theo không?
RFC 9309 ghi rõ robots.txt không phải cơ chế cấp quyền, nhưng nó là cách website nói ra mong muốn của mình. Làm theo robots.txt là chuẩn mực mà các công cụ lớn như Google hay Scrapy đều giữ.
Nên giãn cách giữa các yêu cầu bao lâu?
Không có con số chung. Dự án Scrapy mới mặc định 1 giây giữa hai yêu cầu tới cùng một tên miền là một điểm khởi đầu hợp lý. Nếu website trả về 429 hoặc phản hồi chậm đi, hãy giảm tốc thêm.
Scraping proxy là gì?
Đó là cách gọi các proxy dùng cho việc thu thập dữ liệu, thường là proxy dân cư xoay IP, cho phép chọn quốc gia hay thành phố để lấy kết quả theo đúng vùng.
Có cần proxy để làm web scraping không?
Không phải lúc nào cũng cần. Nếu bạn chỉ lấy ít trang và kết quả không phụ thuộc vị trí, kết nối bình thường là đủ. Proxy hữu ích khi bạn cần kết quả theo vùng, hoặc hệ thống chạy ở quốc gia khác với nơi bạn nghiên cứu.